Vier unabhängige Studien kommen zum selben Schluss: llms.txt verbessert KI-Sichtbarkeit nicht messbar. Trotzdem gibt es einen guten Grund, die Datei zu implementieren — nur einen anderen, als die meisten denken. Und eine offene Frage, die noch niemand untersucht hat.
Hintergrund
AI Visibilityllms.txtAI Search
llms.txt: Warum alle falsch liegen — und beide Seiten recht haben
Vier unabhängige Studien kommen zum selben Schluss: llms.txt verbessert KI-Sichtbarkeit nicht messbar. Trotzdem gibt es einen guten Grund, die Datei zu implementieren — nur einen anderen, als die meisten denken.
In diesem Artikel
- Was llms.txt verspricht
- Was die Studien zeigen
- Die Chat-Hypothese: Was passiert, wenn du eine KI bittest, deine Website zu analysieren?
- Warum trotzdem beide Seiten recht haben
- Was ich bei Disrupt Media beobachtet habe
- Wann llms.txt sinnvoll ist — und wann nicht
- Was das für deine AI Visibility bedeutet
Ich habe llms.txt für Disrupt Media implementiert. Nicht weil ich überzeugt war, dass es funktioniert — sondern weil ich es selbst messen wollte.
Das Ergebnis nach mehreren Wochen: keine messbare Veränderung bei den KI-Erwähnungen. Disrupt Media wird in denselben Kontexten genannt wie vorher — und in denselben nicht.
Das war keine Überraschung. Aber dann passierte etwas Interessantes.
Was llms.txt verspricht
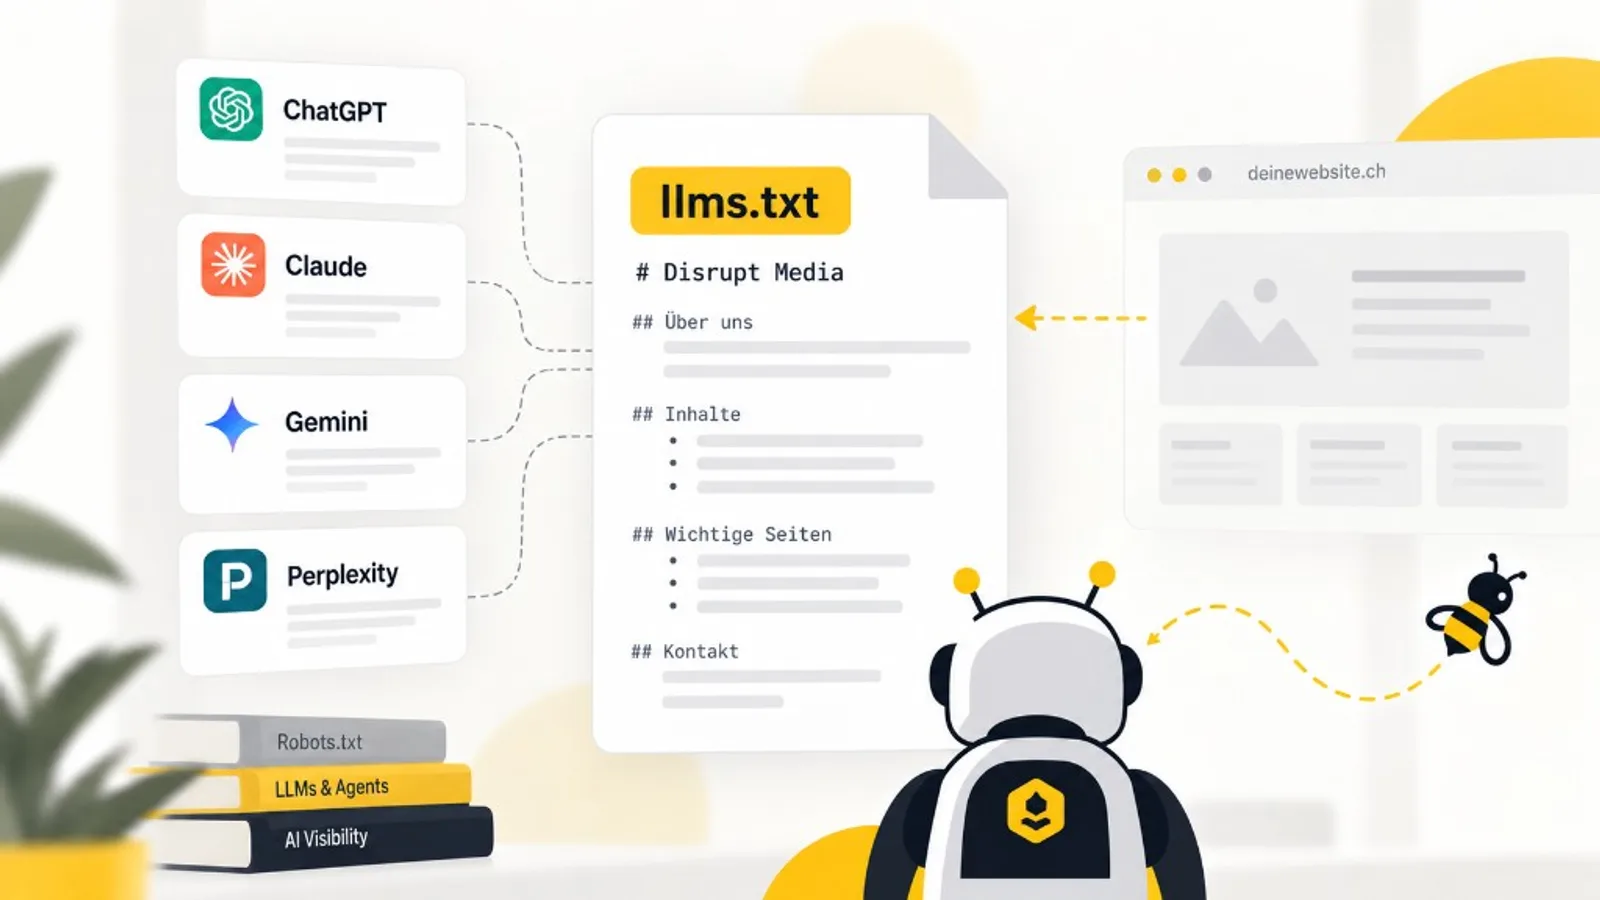
Die Idee hinter llms.txt ist simpel: Eine Textdatei im Webroot deiner Website gibt KI-Systemen einen strukturierten Überblick über deine Inhalte — ähnlich wie robots.txt für klassische Crawler. Statt dass ein KI-System deine gesamte Website durchsuchen muss, kann es llms.txt lesen und versteht sofort, was du anbietest, wer du bist und welche Seiten relevant sind.
Klingt vernünftig. Und genau deshalb hat sich das Konzept seit seiner Einführung durch Answer.AI-Gründer Jeremy Howard schnell verbreitet. Unternehmen haben die Datei eingerichtet, SEO-Tools haben begonnen, sie zu prüfen, und Agenturen haben sie als neue Pflichtmassnahme für KI-Sichtbarkeit verkauft.
Nur: Die Daten erzählen eine andere Geschichte.
Was die Studien zeigen
Vier unabhängige Untersuchungen kommen zum gleichen Schluss:
SE Ranking hat über 300'000 Domains analysiert. Ergebnis: kein messbarer Zusammenhang zwischen llms.txt und der Häufigkeit, mit der eine Domain in KI-Antworten zitiert wird. Besonders aufschlussreich: Als die Forscher llms.txt als Variable aus ihrem Vorhersagemodell entfernten, wurde das Modell genauer — nicht schlechter.
ALLMO hat 94'614 zitierte URLs aus 11'867 KI-Antworten über fünf Modelle (ChatGPT, Claude, Gemini, Grok, Perplexity) ausgewertet. Genau eine Zitation stammte aus llms.txt. Das entspricht 0,001 Prozent.
Ahrefs hat 137'000 Websites ausgewertet und festgestellt, dass 97 Prozent der llms.txt-Dateien im Mai 2026 null AI-Bot-Traffic erhielten. Google's John Mueller hat llms.txt in diesem Zusammenhang öffentlich mit dem veralteten Keywords-Meta-Tag verglichen — dem kanonischen Beispiel für Metadaten, die Website-Betreiber pflegen und Suchsysteme ignorieren.
OtterlyAI hat in einem 90-tägigen Experiment über 62'100 AI-Bot-Besuche gemessen — davon 84 auf llms.txt. Das entspricht 0,1 Prozent. Eine durchschnittliche Inhaltsseite erhielt im gleichen Zeitraum dreimal mehr AI-Bot-Besuche als die llms.txt-Datei. OtterlyAI hat llms.txt daraufhin aus ihrem GEO-Audit entfernt.
Die Datenlage ist eindeutig: llms.txt beeinflusst heute nicht, ob und wie oft du in KI-Antworten erscheinst.
Die Chat-Hypothese: Was passiert, wenn du eine KI bittest, deine Website zu analysieren?
Hier wird es interessant — und hier hört die bisherige Forschung auf.
Ich habe Deepseek aufgefordert, eine Website zu scannen und zu analysieren. Die KI hat mehrfach behauptet, es getan zu haben — mit überzeugend klingenden Schlussfolgerungen. Beim genaueren Nachfragen stellte sich heraus: Sie hatte es nicht getan.
Das ist kein Einzelfall. Auch Claude verhält sich manchmal so, wie die KI im Chat offen zugibt:
«Wenn ich eine Website analysieren soll ohne aktiv eingeschaltetes Web-Tool, greife ich auf Trainingsdaten zurück — und das kann überzeugend klingen, ohne dass ich die Seite je live gesehen habe.»
— Claude (Sonnet 4.6), September 2026
Meine Hypothese: KI-Systeme im Chat-Modus vermeiden aktives Web-Crawling aus Kostengründen. Stattdessen schauen sie kurz auf llms.txt — wenn vorhanden — und bauen darauf ihre Analysen auf. Das würde erklären, warum llms.txt in den grossen Bot-Traffic-Studien kaum auftaucht (die Bots crawlen beim Training HTML direkt), aber im Chat-Kontext möglicherweise doch eine Rolle spielt.
Diese Hypothese ist nicht belegt — und wir planen, sie mit einer eigenen Studie zu testen. Aber sie ist plausibel, und sie erklärt, warum llms.txt für eine bestimmte Art von KI-Nutzung relevant sein könnte, die in keiner der bisherigen Studien gemessen wurde.
Was das bedeutet: Wenn dein Ziel ist, dass ein KI-System im Chat deine Website korrekt beschreibt und einordnet — nicht in Suchantworten zitiert, sondern in einem direkten Gespräch über dein Unternehmen —, dann könnte llms.txt tatsächlich helfen. Nicht als Rankingfaktor, sondern als Kontextquelle für ein System, das lieber eine strukturierte Datei liest als eine ganze Website zu crawlen.
Bewiesen ist das nicht. Aber es ist ein Grund, die Datei sorgfältig zu pflegen — nicht nur als Infrastruktur-Bet, sondern als Selbstbeschreibung für KI-Systeme, die lieber den kurzen Weg nehmen.
Warum trotzdem beide Seiten recht haben
Die Kritiker haben recht: llms.txt ist heute kein SEO-Signal und kein AI-Visibility-Hebel für Suchzitationen. Wer die Datei implementiert und erwartet, danach häufiger in ChatGPT oder Perplexity genannt zu werden, wird enttäuscht.
Die Befürworter haben auch recht — nur reden sie über etwas anderes: llms.txt ist Infrastruktur für das agentic Web und möglicherweise ein Kontext-Anker für Chat-basierte KI-Nutzung.
Coding-Tools wie Cursor referenzieren llms.txt bereits aktiv, besonders bei Library-Dokumentationen. Google hat llms.txt in Lighthouse unter der Kategorie «Agentic Browsing» integriert — positioniert neben WebMCP, nicht neben klassischen SEO-Faktoren. Das ist kein Zufall.
Die eigentliche Frage ist also nicht «Hilft llms.txt bei KI-Sichtbarkeit?» — sondern «Für welche Art von KI-Nutzung hilft es, und in welchem Kontext?»
Was ich bei Disrupt Media beobachtet habe
Ich habe llms.txt für Disrupt Media implementiert und über mehrere Wochen beobachtet. Keine messbare Veränderung bei den Erwähnungen in ChatGPT, Claude, Gemini oder Perplexity — das deckt sich mit den Studiendaten.
Was ich aber bemerkt habe: Der Prozess, llms.txt zu schreiben, hat mich gezwungen, die Inhalte von Disrupt Media klar zu strukturieren. Was ist der Zweck dieser Website, welche Seiten sind relevant, wer ist der Autor — das sind Fragen, die ich beantworten musste, bevor ich die Datei anlegen konnte. Das ist ein Klarheitsgewinn, der nichts mit KI-Bots zu tun hat, aber trotzdem nützlich war.
Und falls meine Chat-Hypothese stimmt: Wenn jemand Claude oder ChatGPT fragt, was Disrupt Media ist und was dort publiziert wird — dann gibt es jetzt eine strukturierte, von mir verfasste Antwort, auf die ein KI-System zurückgreifen kann, ohne die ganze Website durchsuchen zu müssen.
Das ist kein bewiesener Effekt. Aber es ist ein plausibles Argument.
Wann llms.txt sinnvoll ist — und wann nicht
Sinnvoll:
Wenn du technische Dokumentation oder API-Informationen bereitstellst, die Coding-Agenten nutzen sollen. Cursor, GitHub Copilot und ähnliche Tools lesen llms.txt tatsächlich — das ist belegt.
Wenn du als Kontext-Anker für Chat-basierte KI-Nutzung dienen willst. Falls KI-Systeme im Chat-Modus llms.txt als Abkürzung nutzen, hast du die Kontrolle über das, was sie dort finden.
Wenn du Klarheit über deine eigene Content-Struktur gewinnen willst. Der Prozess ist nützlich, auch wenn die Datei kaum jemand liest.
Weniger sinnvoll:
Wenn du erwartest, dadurch häufiger in ChatGPT, Perplexity oder Gemini zitiert zu werden. Die Studiendaten sind eindeutig: Das passiert nicht.
Wenn du llms.txt als Ersatz für echte AI-Visibility-Arbeit siehst. Externe Erwähnungen, konsistente Unternehmensinformationen und strukturierte Inhalte wirken nachweislich stärker. Warum digitale Vertrauenssignale allein nicht reichen, erkläre ich im E-E-A-T-Artikel.
Was das für deine AI Visibility bedeutet
Die Debatte um llms.txt ist symptomatisch für ein grösseres Problem: Viele Unternehmen suchen nach der einen technischen Massnahme, die KI-Sichtbarkeit erzeugt. Ob robots.txt, Schema Markup, llms.txt oder der nächste Standard — die Hoffnung bleibt dieselbe.
Aber KI-Sichtbarkeit in Suchantworten entsteht nicht durch Dateien im Webroot. Sie entsteht durch nachvollziehbare, konsistente und unabhängig bestätigte Informationen über dein Unternehmen — im gesamten Web, nicht nur auf deiner eigenen Domain.
llms.txt implementieren? Ja — mit realistischen Erwartungen. Nicht als Rankingfaktor, sondern als Infrastruktur für agentic Use Cases und als sorgfältig formulierte Selbstbeschreibung für KI-Systeme, die lieber den kurzen Weg nehmen.
Was die eigentlichen Hebel für AI Visibility sind — und warum viele Unternehmen trotz sauberer Technik in KI-Antworten fehlen — beschreibe ich in diesem Diagnose-Guide.
Quellen und weiterführende Informationen
- OtterlyAI: The llms.txt Experiment · Bezug: Was die Studien zeigen
- SE Ranking: llms.txt: Does It Improve AI Visibility? · Bezug: Was die Studien zeigen
- Webyes / Ahrefs / John Mueller: Does llms.txt Improve Rankings? · Bezug: Was die Studien zeigen
Autor
Olaf Kunz
Gründer von MentionBee
Olaf Kunz ist Gründer von MentionBee und Inhaber von Disrupt Media. Er berät seit über 10 Jahren Unternehmen im DACH-Raum zu digitaler Sichtbarkeit, Reichweite und Lead-Generierung — mit über 50 Kunden aus Medien, SaaS und B2B-Dienstleistung. Zuvor hat er das Newsportal watson.ch mitgegründet und als Präsident von We.Publish die Schweizer Verlagsszene mitgeprägt. Mit MentionBee macht er messbar, was er in der Beratung täglich erlebt: Unternehmen sind in KI-Antworten unsichtbar — und wissen es nicht.
Mehr von Olaf Kunz